Emmanuele è giornalista pubblicista, laureato in Ingegneria dell’Informazione e Filosofia. Da oltre 30 anni esplora la tecnologia con focus su privacy, IA e biotech/
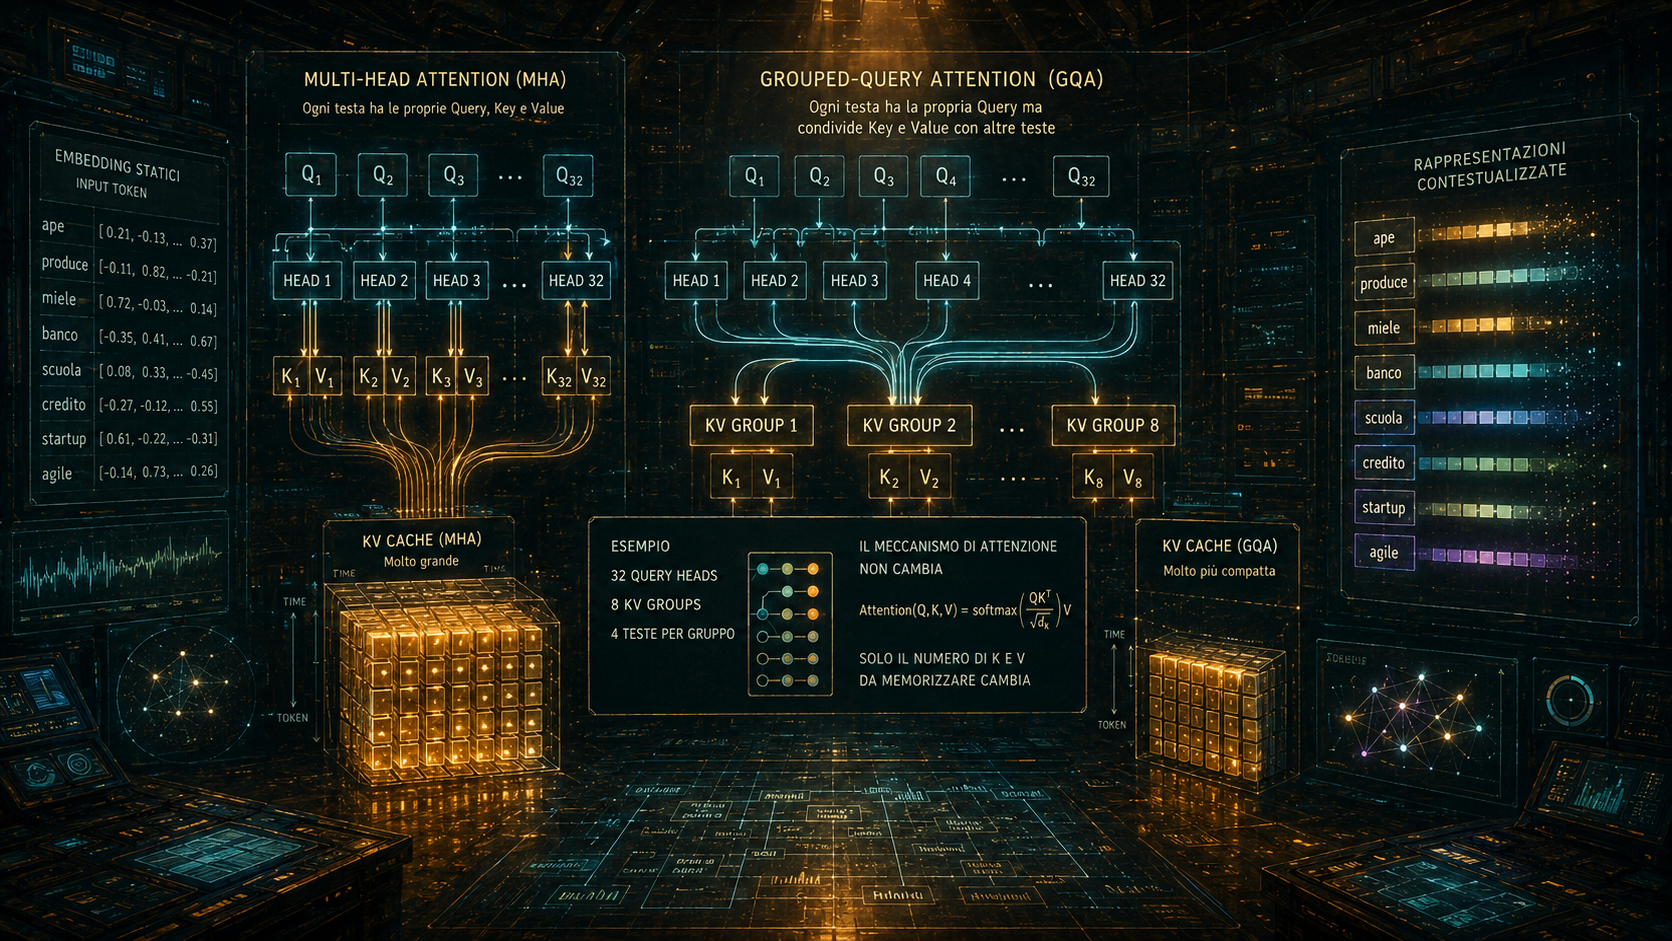
Come rendere la self-attention più efficiente e quali sono i suoi limiti? In questo articolo analizziamo KV cache, Grouped-Query Attention e FlashAttention, per poi affrontare causalità, logica, memoria, verità e sintassi nei moderni modelli linguistici.
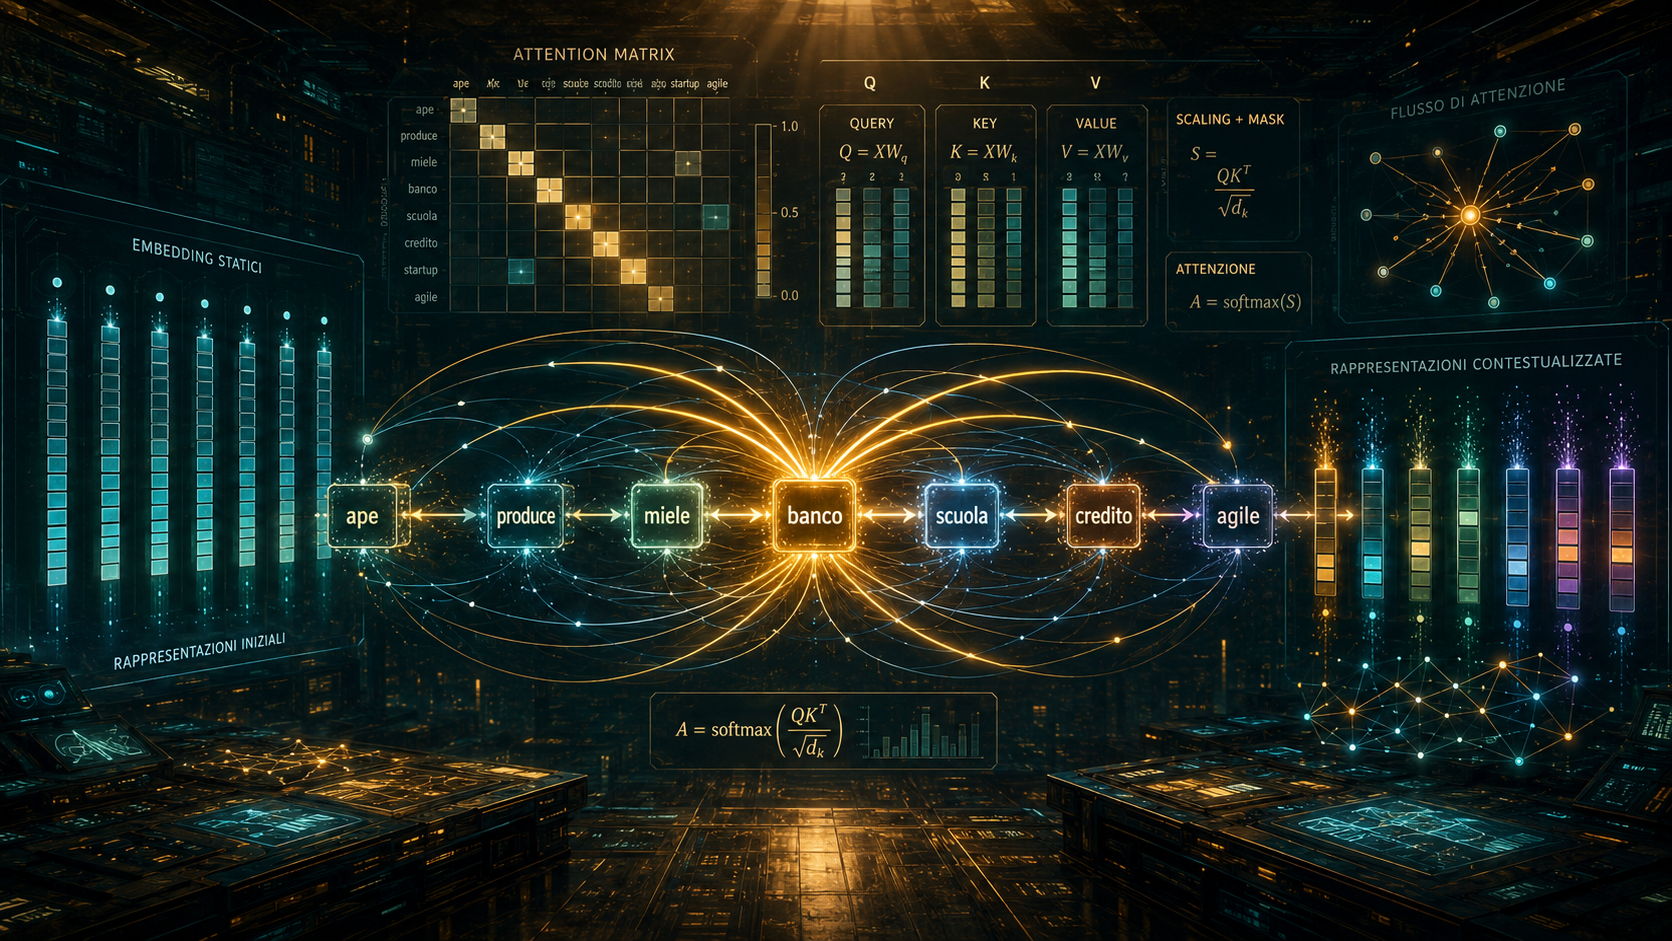
La self-attention è il cuore dei transformer: il meccanismo che trasforma rappresentazioni statiche in rappresentazioni contestualizzate, aggiornando continuamente il significato di ogni token in funzione delle informazioni fornite dagli altri token della sequenza.
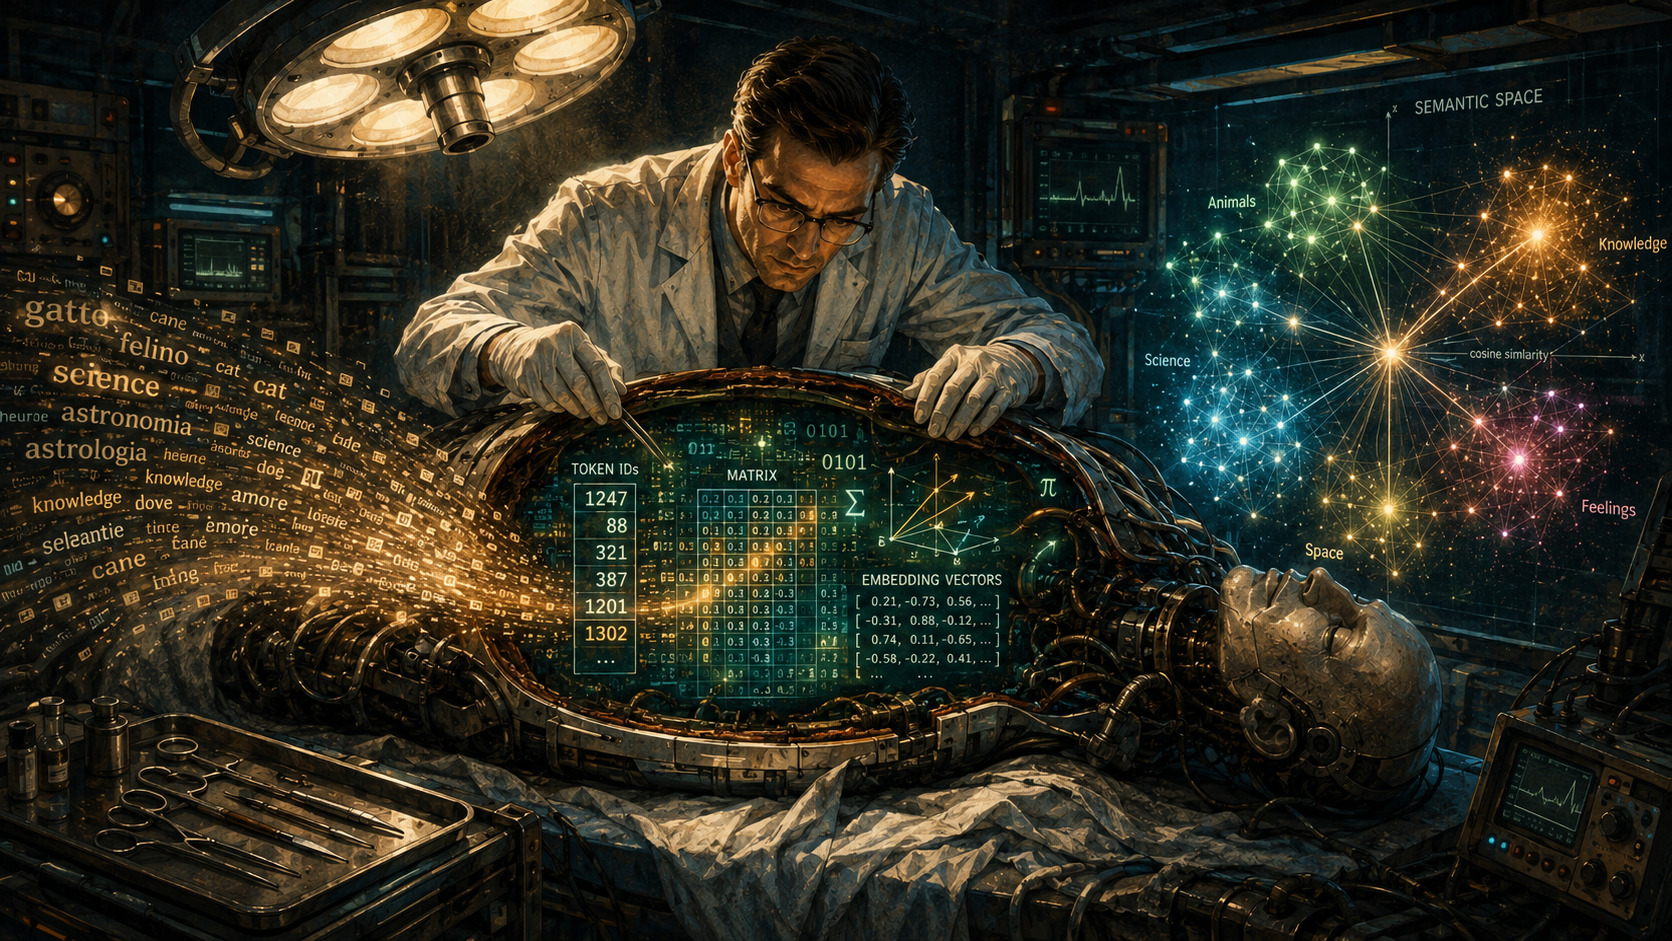
Un modello LLM non riconosce le parole o le frasi come le vedi tu. In realtà non le vede affatto. La trasformazione del testo in ID numerici è il primo passo fondamentale del flusso di lavoro di un LLM. Già a questo punto si introducono delle distorsioni difficili da evitare.
Se non contiene "reti di neuroni" che creano un "cervello elettronico" che gli permette di "pensare" con una vera "intelligenza artificiale", cosa fa veramente un moderno Generative Pre-Trained Transformer come ChatGPT? Un viaggio nella sua matematica di base, alla portata di tutti.