Nella quarta parte abbiamo visto perché gli embedding statici non sono sufficienti a rappresentare il significato di un token all’interno di una frase. Lo stesso token parte infatti sempre dallo stesso vettore iniziale, anche quando viene usato in contesti molto diversi.
La self-attention è un meccanismo estremamente efficace, ma il suo successo dipende anche dalle soluzioni ingegneristiche che ne rendono sostenibile l’uso nei modelli di grandi dimensioni.
La Key Value (KV) cache evita di ricalcolare ad ogni passo le rappresentazioni già prodotte, la Grouped-Query Attention riduce il numero di Key e Value da conservare in memoria e tecniche come FlashAttention limitano il movimento dei dati durante il calcolo. Queste ottimizzazioni non cambiano il principio fondamentale dell’attenzione, ma ne migliorano drasticamente l’efficienza pratica.
Allo stesso tempo, la self-attention non fornisce da sola una rappresentazione esplicita di causalità, logica, verità, memoria a lungo termine o struttura sintattica. I transformer possono apprendere comportamenti che sembrano affrontare questi problemi, ma tali capacità emergono dall’interazione tra architettura, dati, obiettivi di addestramento e profondità del modello.
Comprendere la self-attention significa quindi riconoscerne sia la potenza sia i limiti. È il principale meccanismo attraverso cui le posizioni di una sequenza scambiano informazioni, ma non coincide con l’intero funzionamento di un LLM e non basta, da sola, a spiegare tutte le capacità che osserviamo nei modelli moderni.Il problema nascosto della memoria
Dal punto di vista teorico la Multi-Head Attention funziona molto bene; tuttavia, dal punto di vista ingegneristico, introduce un problema considerevole: durante la generazione autoregressiva il modello produce un token alla volta.
Quando genera il token successivo non ha alcun interesse a ricalcolare le rappresentazioni di tutti i token precedenti, che sono già state elaborate.
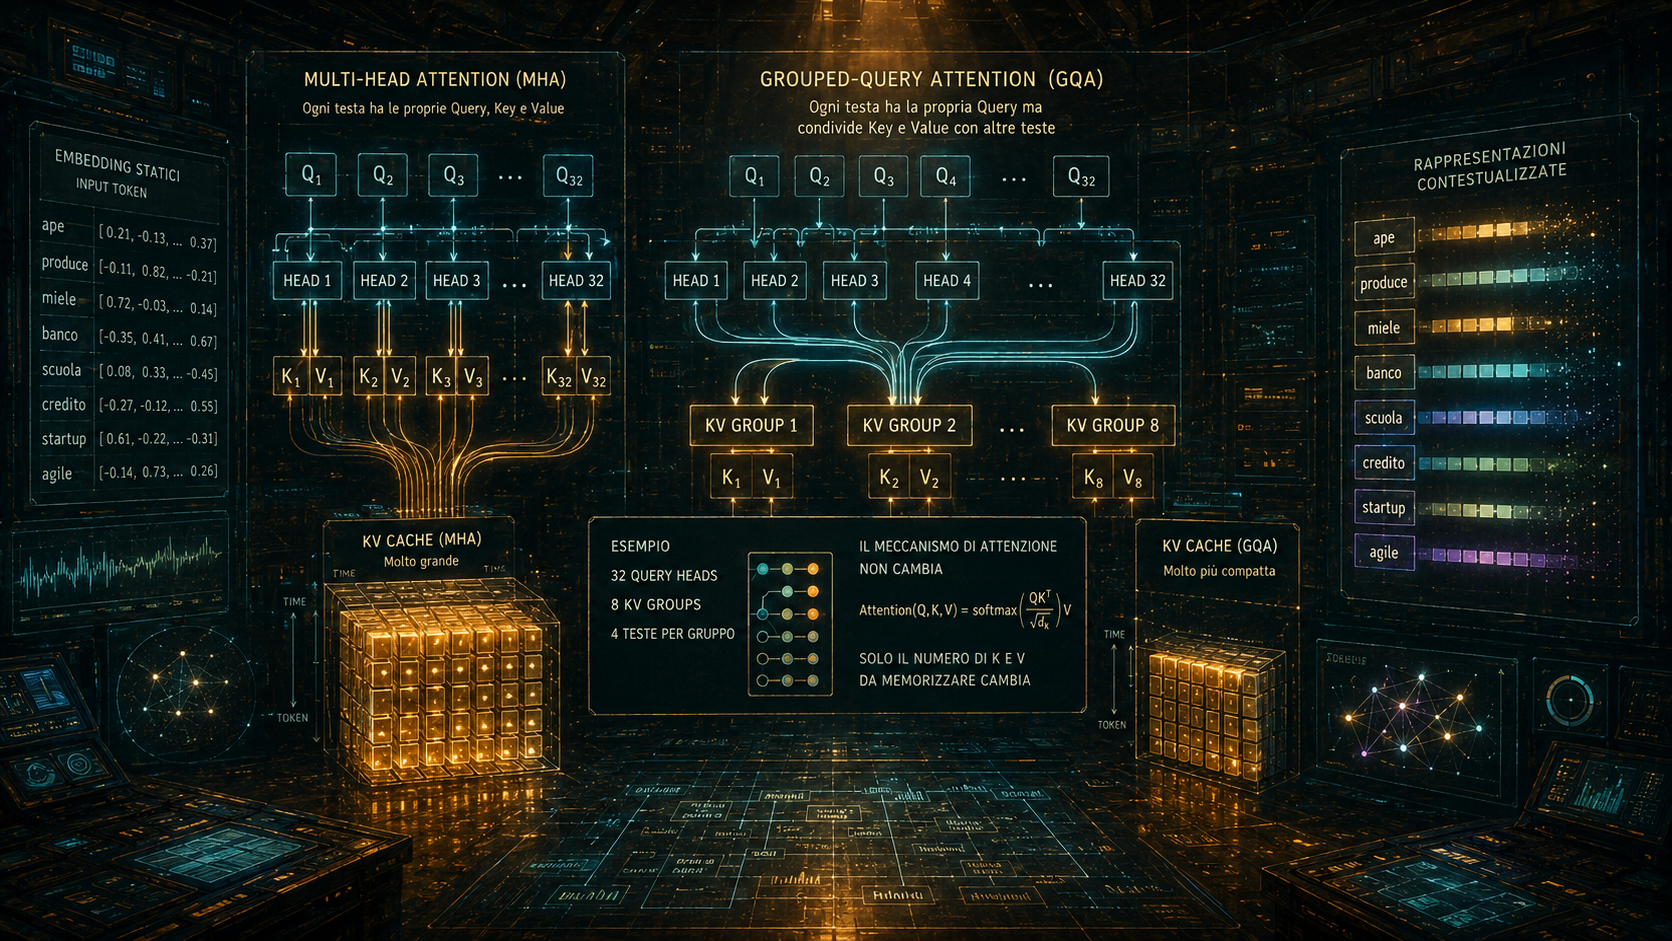
Per evitare questo spreco di calcolo, il modello conserva in memoria le Key e i Value prodotti per ogni layer e per ogni token già elaborato. Questa struttura prende il nome di KV Cache. Quando arriva una nuova Query è sufficiente confrontarla con le Key memorizzate e utilizzare i Value già disponibili, evitando di rieseguire l'intero calcolo sulla sequenza. Senza questa cache la generazione sarebbe enormemente più lenta.
Il costo della KV Cache
La cache, però, cresce linearmente con il numero di token. Nei modelli con finestre di contesto molto lunghe questo diventa rapidamente uno dei principali consumi di memoria: per ogni token occorre infatti conservare, per ogni layer, tutti i vettori Key e Value.
Su contesti dell'ordine di centinaia di migliaia di token il consumo di memoria può raggiungere decine di gigabyte, fino a diventare uno dei principali limiti pratici nell'esecuzione dei modelli.
È interessante osservare che, nei sistemi moderni, il collo di bottiglia non è sempre la quantità di operazioni matematiche: molto spesso è la quantità di dati che devono essere mantenuti e trasferiti continuamente tra memoria e GPU.
Ridurre il traffico di memoria può produrre miglioramenti prestazionali anche senza diminuire significativamente il numero di operazioni aritmetiche.
Grouped-Query Attention
Per affrontare questo problema sono state proposte diverse varianti dell'attenzione. Una delle più efficaci è la Grouped-Query Attention (GQA), adottata anche da Llama 3.1.
L'idea è sorprendentemente semplice: nella Multi-Head Attention tradizionale ogni testa possiede la propria Query, la propria Key e il proprio Value. Con GQA, invece, ogni testa mantiene la propria Query ma più teste condividono lo stesso insieme di Key e Value.
In altre parole, diminuisce il numero di rappresentazioni che devono essere memorizzate nella cache, mentre rimane invariata la possibilità di formulare interrogazioni differenti attraverso Query indipendenti.
Ad esempio, se il modello utilizza trentadue teste Query ma soltanto otto gruppi Key-Value, ogni gruppo viene condiviso da quattro teste.
Dal punto di vista matematico il meccanismo dell'attenzione rimane invariato, ciò che cambia è soltanto il numero di Key e Value distinti che devono essere mantenuti in memoria. Il risultato è una riduzione molto significativa della KV Cache.
Perché la perdita di qualità è contenuta
A prima vista questa modifica potrebbe sembrare drastica: condividere le stesse Key e gli stessi Value tra più teste significa infatti ridurre la libertà rappresentazionale del modello.
In effetti una perdita esiste: le teste non possono più sviluppare rappresentazioni completamente indipendenti, ma devono condividere parte della loro struttura informativa. Tuttavia, gli esperimenti mostrano che questa limitazione incide molto meno di quanto si potrebbe immaginare.
Una possibile interpretazione è che molte delle informazioni apprese dalle varie teste siano in parte ridondanti. Consentire loro di condividere Key e Value riduce la memoria richiesta senza compromettere in modo significativo la qualità delle rappresentazioni.
Non esiste però una dimostrazione teorica definitiva di questo comportamento; sappiamo semplicemente che, nella pratica, il compromesso funziona molto bene.
È un esempio interessante di come l'evoluzione dei transformer non proceda soltanto attraverso nuove idee teoriche, ma anche attraverso soluzioni ingegneristiche che rendono il modello più efficiente senza modificarne i principi fondamentali.
FlashAttention: ridurre il movimento dei dati
La Grouped-Query Attention riduce la quantità di Key e Value che devono essere conservati durante la generazione. FlashAttention interviene invece sul modo in cui il calcolo dell’attenzione viene eseguito sulla GPU.
Nell’implementazione tradizionale, la matrice completa dei punteggi di attenzione viene materializzata e trasferita più volte tra diversi livelli di memoria. Poiché questi spostamenti possono diventare più costosi delle stesse operazioni aritmetiche, FlashAttention suddivide il calcolo in blocchi abbastanza piccoli da essere elaborati nella memoria veloce del processore.
Il risultato matematico rimane quello dell’attenzione standard: FlashAttention non è un’approssimazione e non modifica i pesi del modello. Cambia soltanto l’ordine con cui le operazioni vengono eseguite, riducendo gli accessi alla memoria e accelerando il calcolo, soprattutto sulle sequenze lunghe.
Nella prossima parte analizzeremo invece un aspetto completamente diverso: i limiti della self-attention. Dopo aver visto ciò che questo meccanismo riesce a fare straordinariamente bene, sarà il momento di capire anche ciò che, per sua natura, non può fare o riesce a fare soltanto in modo approssimato.
I limiti della self-attention: cosa il transformer non vede
Dopo aver studiato il funzionamento della self-attention è facile lasciarsi convincere dalla sua eleganza. Partendo da semplici operazioni di algebra lineare, il modello riesce a trasformare rappresentazioni statiche in rappresentazioni contestualizzate, a catturare dipendenze tra parole lontane e a costruire descrizioni della frase sempre più ricche man mano che attraversa i layer del transformer.
Tutto questo è reale. Sarebbe però un errore concludere che la self-attention costituisca una forma generale di comprensione.
Il successo dei moderni LLM deriva in larga misura dall'efficacia di questo meccanismo, ma la self-attention rimane un algoritmo con caratteristiche ben precise. Comprendere i suoi limiti è importante quanto comprenderne i punti di forza, perché permette di interpretare correttamente sia le capacità sia gli errori dei modelli.
In molti casi questi limiti non sono assoluti. Il modello può imparare ad aggirarli grazie all'addestramento, ai layer successivi o ad altri componenti dell'architettura. Tuttavia esistono problemi per i quali la self-attention, presa isolatamente, non fornisce una soluzione esplicita.
Similarità non significa causalità
L'attenzione nasce per confrontare rappresentazioni vettoriali. Il suo meccanismo fondamentale consiste nel misurare la compatibilità tra Query e Key attraverso il prodotto scalare. Questo funziona molto bene quando l'obiettivo è individuare quali token siano informativamente rilevanti gli uni per gli altri.
La causalità, però, è un concetto diverso: consideriamo una frase come
Se piove, il concerto sarà rinviato.
Per un lettore umano la struttura è immediata. La pioggia rappresenta una condizione dalla quale discende una conseguenza; nel meccanismo di attenzione però, non esiste una componente dedicata alla rappresentazione di relazioni causali.
Il modello può certamente imparare che parole come "se", "allora", "perché" o "quindi" compaiono spesso in determinati contesti e utilizzare questi schemi durante la generazione. Ma questa conoscenza emerge indirettamente dai dati di addestramento; non deriva da una nozione esplicita di causa ed effetto incorporata nell'algoritmo.
Questo non significa che gli LLM siano incapaci di ragionare su relazioni causali. Significa piuttosto che la causalità non è una proprietà fondamentale della self-attention. Quando il modello produce risposte convincenti su questi temi, il comportamento emerge dall'interazione di molti componenti e dall'enorme quantità di esempi osservati durante il training.
La logica non è codificata nell'attenzione
Una considerazione analoga vale per la logica: frasi come
Il cane è marrone.
e
Il cane non è marrone.
sono quasi identiche dal punto di vista lessicale. Differiscono per un solo token, ma quel token cambia completamente il significato dell'enunciato.
La self-attention non possiede una rappresentazione formale della negazione. Non applica regole logiche e non costruisce dimostrazioni.
Ancora una volta, il modello può imparare a gestire correttamente moltissimi casi osservando esempi durante l'addestramento. Infatti i moderni LLM trattano generalmente la negazione molto meglio di quanto farebbe un semplice sistema basato sulla similarità.
Tuttavia, quando il ragionamento richiede catene logiche lunghe, deduzioni rigorose oppure la gestione simultanea di molte proposizioni in conflitto, gli errori diventano più frequenti.
Questo non dipende esclusivamente dalla self-attention, ma riflette un limite più generale dell'architettura transformer, che non implementa un motore inferenziale simbolico.
L'aritmetica emerge dai dati, non da un algoritmo
Un altro esempio interessante riguarda il calcolo numerico.
Se chiediamo a un LLM di sommare due numeri relativamente semplici, spesso otteniamo la risposta corretta. È naturale domandarsi se il modello abbia imparato l'algoritmo dell'addizione.
Le evidenze disponibili suggeriscono una risposta più sfumata: per operazioni frequenti e di dimensioni moderate il modello riesce spesso a riprodurre procedure che assomigliano a un algoritmo. Tuttavia questa capacità degrada progressivamente quando i numeri diventano molto lunghi oppure quando il problema si allontana dagli esempi osservati durante il training.
Non bisogna quindi immaginare che all'interno del transformer esista un'unità dedicata all'aritmetica; le operazioni numeriche vengono affrontate attraverso le stesse rappresentazioni distribuite utilizzate per il linguaggio.
Per questo motivo molti sistemi moderni preferiscono delegare i calcoli esatti a strumenti esterni, come interpreti Python o calcolatrici simboliche, lasciando al modello il compito di comprendere il problema e orchestrare la soluzione.
Il limite della finestra di contesto
La self-attention può utilizzare soltanto le informazioni presenti nella finestra di contesto.
Negli ultimi anni questa finestra è cresciuta enormemente: da poche migliaia di token si è arrivati a centinaia di migliaia, ma ciò non cambia la natura del problema: qualunque finestra, per quanto ampia, rimane finita.
Se una conversazione, un libro o una base documentale superano questa dimensione, parte delle informazioni non potrà essere considerata direttamente dal meccanismo di attenzione.
Questo non significa che i modelli moderni siano privi di memoria: molti sistemi integrano memorie esterne, recupero documentale (Retrieval-Augmented Generation), profili utente persistenti o altre tecniche che permettono di reintrodurre nel contesto informazioni rilevanti.
È importante però distinguere questi meccanismi dalla self-attention; l'attenzione opera esclusivamente sul contesto disponibile in quel momento, mentre la memoria a lungo termine, quando esiste, è ottenuta attraverso componenti aggiuntivi.
Correlazione e verità
Probabilmente il limite più importante riguarda il rapporto tra correlazione e conoscenza del mondo.
Durante l'addestramento il modello osserva enormi quantità di testo provenienti da fonti molto diverse; alcuni documenti descrivono accuratamente la realtà, altri contengono opinioni, errori, narrativa, propaganda o informazioni obsolete.
L'obiettivo del training non consiste nel distinguere il vero dal falso: consiste nel prevedere il token successivo.
Di conseguenza il modello apprende regolarità statistiche del linguaggio, non una teoria della verità. Questo spiega perché un LLM possa produrre affermazioni estremamente plausibili anche quando risultano inesatte; la plausibilità linguistica e la correttezza fattuale sono due proprietà differenti.
Negli ultimi anni tecniche come il reinforcement learning, il fine tuning supervisionato e l'integrazione con motori di ricerca hanno migliorato significativamente l'affidabilità dei modelli, ma il principio fondamentale rimane invariato: la self-attention organizza informazione statistica, non verifica la verità delle affermazioni.
Gerarchie e strutture sintattiche
Anche la sintassi mette in evidenza un aspetto interessante: le lingue naturali possiedono una struttura gerarchica.
Le proposizioni possono essere annidate, i sintagmi possono contenere altri sintagmi e il significato dipende spesso dalla struttura dell'albero sintattico più che dalla semplice successione lineare delle parole.
La self-attention non costruisce esplicitamente questi alberi, lavora invece attraverso relazioni pesate tra coppie di token.
Ciò non significa che il modello ignori la sintassi. Numerosi studi mostrano che molte informazioni sintattiche emergono spontaneamente nelle rappresentazioni interne dei transformer.
La differenza è che questa struttura non viene rappresentata come un oggetto simbolico separato: è distribuita nello spazio vettoriale e ricostruita implicitamente attraverso l'interazione di molti layer.
Per frasi comuni questo approccio funziona sorprendentemente bene. Quando però la complessità sintattica aumenta molto, gli errori tendono a diventare più frequenti.
Perché, allora, i transformer funzionano così bene?
A questo punto potrebbe sorgere un dubbio: se la self-attention non rappresenta direttamente causalità, logica, memoria illimitata o verità, come fanno gli LLM a ottenere risultati tanto convincenti?
La risposta è che nessuna di queste capacità dipende da un singolo componente.
Un transformer è un sistema complesso nel quale la self-attention costituisce soltanto uno degli elementi fondamentali.
Le rappresentazioni vengono continuamente trasformate dai layer feed-forward, stabilizzate dalle normalizzazioni, propagate attraverso le connessioni residue e affinate lungo decine di blocchi successivi. Inoltre il modello è stato addestrato su quantità di testo talmente grandi da consentirgli di apprendere una straordinaria varietà di regolarità statistiche.
Molti problemi che, in teoria, richiederebbero ragionamento simbolico possono essere affrontati in modo sorprendentemente efficace attraverso rappresentazioni distribuite sufficientemente ricche.
Questo non elimina i limiti dell'architettura, ma aiuta a spiegare perché essi emergano soprattutto nei casi più difficili, mentre rimangano quasi invisibili nella maggior parte delle conversazioni quotidiane.
Conclusioni
Il problema da cui siamo partiti era apparentemente semplice: gli embedding statici assegnano sempre la stessa rappresentazione a un token, indipendentemente dal contesto.
La self-attention risolve questo limite costruendo rappresentazioni dinamiche che dipendono dall'intera sequenza.
Per farlo trasforma ogni rappresentazione in Query, Key e Value, misura la compatibilità tra i token, distribuisce l'attenzione attraverso la funzione Softmax e combina le informazioni rilevanti in una nuova rappresentazione contestualizzata.
Ripetuto lungo decine di layer e moltiplicato per miliardi di parametri, questo processo permette ai transformer di costruire descrizioni del linguaggio straordinariamente ricche.
La Multi-Head Attention amplia ulteriormente questa capacità consentendo al modello di osservare contemporaneamente la stessa sequenza da prospettive differenti, mentre ottimizzazioni come la Grouped-Query Attention rendono possibile utilizzare queste architetture su finestre di contesto sempre più estese senza costi proibitivi di memoria.
La self-attention, tuttavia, non coincide con la comprensione nel senso umano del termine: è un meccanismo matematico estremamente efficace per costruire rappresentazioni contestualizzate, ma non incorpora esplicitamente concetti come causalità, logica formale o verità.
Comprendere questo aspetto è importante quanto comprenderne il funzionamento: da un lato permette di apprezzare perché i transformer abbiano rivoluzionato l'elaborazione del linguaggio naturale; dall'altro evita di attribuire loro proprietà che non possiedono e aiuta a interpretarne correttamente sia i successi sia gli errori.
Nel prossimo articolo lasceremo il meccanismo di attenzione e seguiremo il percorso delle rappresentazioni attraverso il resto del blocco transformer. Vedremo infatti che la self-attention non conclude l'elaborazione di un layer: dopo aver costruito rappresentazioni contestualizzate, entra in gioco un secondo componente altrettanto importante, il feed-forward network, che trasforma ulteriormente queste rappresentazioni prima di passarle al layer successivo. È proprio dall'alternanza tra attenzione e trasformazione non lineare che nasce gran parte della capacità espressiva dei moderni transformer.
Bibliografia
- Ainslie, J., Lee-Thorp, J., de Jong, M., Zemlyanskiy, Y., Lebrón, F., & Sanghai, S. (2023). GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints. https://arxiv.org/abs/2305.13245
- Dao, T., Fu, D. Y., Ermon, S., Rudra, A., & Ré, C. (2022). FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness. https://arxiv.org/abs/2205.14135
- Liu, N. F., Lin, K., Hewitt, J., et al. (2023). Lost in the Middle: How Language Models Use Long Contexts. https://arxiv.org/abs/2307.03172
- Lin, S., Hilton, J., & Evans, O. (2021). TruthfulQA: Measuring How Models Mimic Human Falsehoods. https://arxiv.org/abs/2109.07958
- Ahuja, K., Balachandran, V., Panwar, M., et al. (2024). Learning Syntax Without Planting Trees: Understanding When and Why Transformers Generalize Hierarchically. https://arxiv.org/abs/2404.16367