
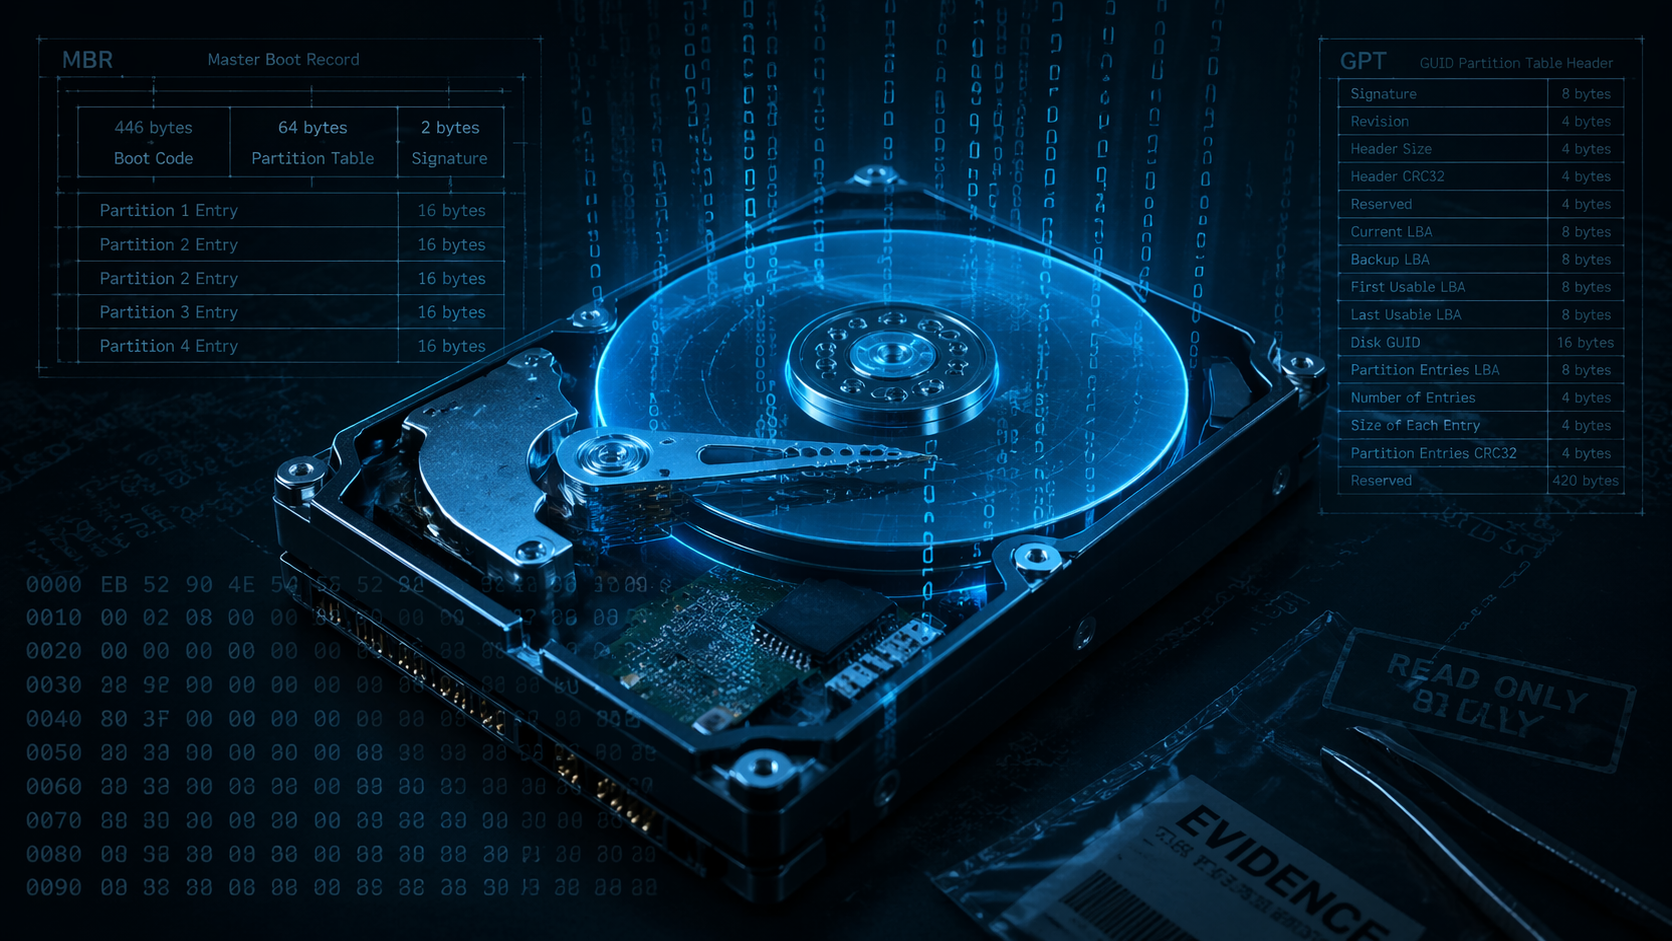
Se avete mai fatto analisi forense su un dispositivo di archiviazione (o anche solo se vi è capitato di sudare freddo davanti a un disco "morto"), sapete bene di cosa parlo. Corruzione logica, cancellazione accidentale o alterazione intenzionale delle tabelle delle partizioni, impossassioni cyber-demoniache. Il disco sembra inaccessibile, ma i dati sotto ci sono ancora. In questi casi serve un cyber-esorcista con strumenti affidabili, trasparenti e, soprattutto, verificabili.
È qui che entra in gioco TestDisk. Creato nel lontano 1998 da Christophe Grenier (e ancora oggi attivamente mantenuto [1]), è diventato uno degli strumenti open source più solidi per ripristinare partizioni perse e riparare settori di avvio. Qualche anno dopo, nel 2002, gli è stato affiancato PhotoRec, un file carver capace di recuperare oltre 480 formati di file, fregandosene allegramente della struttura del file system [2].
Il tutto è sotto licenza GNU GPL. Questo è un regalo enorme per la comunità scientifica forense: significa poter verificare formalmente come funzionano gli algoritmi, soddisfacendo quei requisiti di ripetibilità e trasparenza che in tribunale fanno la differenza. Insomma Grenier è il Mosè che ha condotto i forensi attraverso il deserto della perdita dei dati senza far pagare nulla.
In questo articolo vi porto a fare un giro sotto il cofano di questa codebase, per capire le scelte implementative, gli algoritmi e le strutture dati che la fanno girare, con un occhio di riguardo alle implicazioni forensi discusse nella documentazione ufficiale [3].
Come è costruita la Codebase
TestDisk è scritto quasi tutto in C (standard C99) ed è super modulare. Sì, lo so, il C non è object-oriented, ma gli sviluppatori sono stati furbi: hanno usato il pattern delle vtable (strutture con puntatori a funzione) per ottenere un polimorfismo a runtime di fatto.
Organizzazione dei moduli
Se aprite la directory src/, trovate tutta la logica divisa per aree funzionali:
| Macro-area | File principali | Descrizione |
|---|---|---|
| Astrazione Hardware | hdaccess.c, hdcache.c, ewf.c |
Accesso ai dispositivi fisici, cache I/O, immagini forensi |
| Tabelle Partizioni | parti386.c, partgpt.c, partmac.c, partsun.c |
Lettura/scrittura MBR, GPT, APM, Sun |
| Rilevamento Architettura | partauto.c, autoset.c |
Identificazione automatica del tipo di tabella |
| Analisi File System | fat.c, ntfs.c, ext2.c, hfs.c, xfs.c, ... |
Validazione e recupero per ogni FS supportato |
| Ricerca Partizioni | godmode.c, next.c, tanalyse.c |
Scansione euristica del disco |
| File Carving | photorec.c, psearchn.c, filegen.c, file_*.c |
Pattern matching e recupero file |
| Interfaccia Utente | intrf.c, intrfn.c |
UI testuale (ncurses) e modalità batch |
| Utilità Forensi | hidden.c, savehdr.c, crc.c |
HPA/DCO, backup header, checksum CRC32 |
Le strutture dati che contano
Tutto ruota attorno ad astrazioni hardware che non dipendono dal sistema operativo. Il cuore è la struttura disk_t (definita in common.h), che racchiude le info fisiche e logiche del disco e definisce i puntatori per l'I/O.
/* Estratto semplificato da common.h */
struct param_disk_struct
{
  char description_txt[DISKDESCRIPTION_MAX]; /* Stringa descrittiva */
  CHSgeometry_t geom;           /* Geometria CHS logica */
  uint64_t disk_size;           /* Dimensione totale in byte */
  uint64_t disk_real_size;      /* Dimensione fisica reale */
  char *device;                 /* Percorso del device (es. /dev/sda) */

  /* Puntatori a funzione per I/O indipendente dal dispositivo */
  int (*pread)(disk_t *disk, void *buf,
               const unsigned int count, const uint64_t offset);
  int (*pwrite)(disk_t *disk, const void *buf,
                const unsigned int count, const uint64_t offset);

  /* Interfaccia dell'architettura della tabella partizioni */
  const arch_fnct_t *arch;

  /* Campi per rilevamento HPA/DCO */
  uint64_t user_max;            /* Settori massimi accessibili dall'utente */
  uint64_t native_max;          /* Settori fisici reali */
  uint64_t dco;                 /* Device Configuration Overlay */

  unsigned int sector_size;     /* Dimensione del settore logico */
  void *data;                   /* Dati privati del driver (es. handle EWF) */
};
Perché è importante per noi analisti? Perché grazie a queste funzioni pread e pwrite, il tool non legge solo i dischi fisici raw (/dev/sda), ma digerisce benissimo anche immagini forensi in formato EWF/E01 (grazie a libewf), file raw e loopback. In pratica, potete lavorare sulla copia dell'evidenza senza sfiorare l'originale.
Un'altra struttura da tenere d'occhio è partition_t, che mappa la singola partizione logica: dove inizia (part_offset), quanto è grande (part_size), il suo stato e il file system rilevato (upart_type).
Polimorfismo fatto in casa
Per astrarre le tabelle delle partizioni, usano la struttura arch_fnct_t:
/* Estratto da common.h */
struct arch_fnct_struct
{
  const char *part_name;        /* Nome dell'architettura (es. "Intel") */
  const char *part_name_option; /* Opzione CLI (es. "i386") */

  /* Lettura della tabella partizioni dal disco */
  list_part_t *(*read_part)(disk_t *disk,
                             const int verbose, const int saveheader);

  /* Scrittura della tabella partizioni sul disco */
  int (*write_part)(disk_t *disk, const list_part_t *list_part,
                    const int ro, const int verbose);

  /* Verifica di una singola partizione */
  int (*check_part)(disk_t *disk, const int verbose,
                    partition_t *partition, const int saveheader);

  /* Recupero dei parametri di partizione da un boot sector */
  int (*recover_part)(disk_t *disk, const unsigned char *buffer,
                      partition_t *partition, ...);
};
Ogni architettura (che sia arch_i386, arch_gpt o arch_mac) implementa questa interfaccia. Così il codice di alto livello se ne frega di cosa sta leggendo e lavora in modo uniforme.
Come capisce cosa sta leggendo?
Prima di fare danni, TestDisk deve capire che tabella partizioni ha davanti. Ci pensa autodetect_arch() in partauto.c.
L'algoritmo va per tentativi, partendo dagli standard più comuni:
/* Estratto da partauto.c - Logica di autodetect */
void autodetect_arch(disk_t *disk, const arch_fnct_t *arch)
{
  list_part_t *list_part = NULL;

  /* 1. Prova con arch_none (dischi senza tabella partizioni) */
  disk->arch = &arch_none;
  list_part = arch_none.read_part(disk, verbose, 0);

  /* 2. Prova con GPT (GUID Partition Table - standard moderno) */
  if(list_part == NULL) {
    disk->arch = &arch_gpt;
    list_part = arch_gpt.read_part(disk, verbose, 0);
  }

  /* 3. Prova con MBR Intel (standard PC legacy) */
  if(list_part == NULL) {
    disk->arch = &arch_i386;
    list_part = arch_i386.read_part(disk, verbose, 0);
  }

  /* ... altri tentativi con arch_mac, arch_sun, arch_xbox ... */

  /* Fallback basato sulla dimensione del disco */
  if(disk->disk_size < ((uint64_t)1 << (32 + 9)))
    disk->arch = &arch_i386;  /* < 2 TB: usa MBR */
  else
    disk->arch = &arch_gpt;   /* >= 2 TB: usa GPT */
}
In ambito forense questa euristica è oro colato, specialmente quando qualcuno ha cercato di alterare o corrompere deliberatamente la tabella.
Dentro la tabella MBR e GPT
La vecchia MBR
Se aprite parti386.c, trovate la struttura partition_dos che mappa esattamente i 16 byte di una voce MBR:
/* Estratto da parti386.c */
#define TAB_PART 0x1BE  /* Offset della tabella partizioni nell'MBR */

struct partition_dos {
  unsigned char boot_ind;   /* 0x80 = attiva (bootable) */
  unsigned char head;       /* Testa CHS di inizio */
  unsigned char sector;     /* Settore CHS di inizio (bit 6-7 = cyl alto) */
  unsigned char cyl;        /* Cilindro CHS di inizio (8 bit bassi) */
  unsigned char sys_ind;    /* Tipo di partizione (es. 0x07=NTFS, 0x0B=FAT32) */
  unsigned char end_head;   /* Testa CHS di fine */
  unsigned char end_sector; /* Settore CHS di fine */
  unsigned char end_cyl;    /* Cilindro CHS di fine */
  unsigned char start4[4];  /* LBA di inizio (little-endian 32-bit) */
  unsigned char size4[4];   /* Numero di settori (little-endian 32-bit) */
};

/* Macro per l'estrazione dei campi CHS compressi */
#define s_cyl(p)  (((p)->cyl & 0xff) | (((p)->sector << 2) & 0x300))
#define s_sect(p) ((p)->sector & 0x3f)
#define e_cyl(p)  (((p)->end_cyl & 0xff) | (((p)->end_sector << 2) & 0x300))
#define e_sect(p) ((p)->end_sector & 0x3f)
Quelle macro per la codifica CHS compressa (24 bit spalmati tra cilindro, testa e settore) sono il motivo per cui questo tool legge dischi legacy senza battere ciglio.
L'header GPT
Per i dischi moderni (partgpt.c), la struttura è questa:
/* Estratto da partgpt.h */
struct gpth {
  uint64_t Signature;           /* "EFI PART" (0x5452415020494645) */
  uint32_t Revision;            /* Versione (es. 0x00010000 = 1.0) */
  uint32_t HeaderSize;          /* Dimensione header (92 byte) */
  uint32_t HeaderCRC32;         /* CRC32 dell'header (campo azzerato per il calcolo) */
  uint32_t Reserved;
  uint64_t MyLBA;               /* LBA di questo header */
  uint64_t AlternateLBA;        /* LBA dell'header di backup */
  uint64_t FirstUsableLBA;      /* Primo LBA utilizzabile per le partizioni */
  uint64_t LastUsableLBA;       /* Ultimo LBA utilizzabile */
  efi_guid_t DiskGUID;          /* GUID univoco del disco */
  uint64_t PartitionEntryLBA;   /* LBA del primo entry della tabella */
  uint32_t NumberOfPartitionEntries; /* Numero di entry (tipicamente 128) */
  uint32_t SizeOfPartitionEntry; /* Dimensione di ogni entry (128 byte) */
  uint32_t PartitionEntryArrayCRC32; /* CRC32 dell'array */
} __attribute__ ((packed));
Il trucco qui è che TestDisk sa sfruttare il fatto che GPT ha un header primario (LBA 1) e uno di backup (alla fine del disco). Se il primo è saltato, va a pescare il secondo, validando tutto col CRC32.
Quando tutto è perduto: la ricerca euristica
Se la tabella è andata, si passa alle maniere forti: la scansione avanzata (godmode.c).
Scansione intelligente
Leggere settore per settore un disco da svariati terabyte vi farebbe invecchiare davanti al monitor. In next.c, TestDisk usa un algoritmo di salto euristico basato su dove dovrebbero trovarsi i file system:
/* Estratto da next.c - Funzione search_location_init */
void search_location_init(const disk_t *disk_car,
                          const unsigned int location_boundary,
                          const int fast_mode)
{
  /* Allineamento al cilindro: H=0,1,2 S=1 (dischi MBR legacy) */
  search_location_info[n].offset = CHS_to_offset(0, 0, 1, disk_car);
  search_location_info[n].inc    = CHS_to_offset(1, 0, 0, disk_car);

  /* Allineamento al Megabyte (standard moderno: 2048 settori da 512 byte) */
  search_location_info[n].offset = 0;
  search_location_info[n].inc    = 2048 * 512;

  /* Backup boot sector FAT32 (tipicamente al settore 6) */
  search_location_info[n].offset = CHS_to_offset(0, 0, 7, disk_car);

  /* Backup boot sector NTFS (ultimo settore della partizione) */
  search_location_info[n].offset = CHS_to_offset(1, 0, -1, disk_car);

  /* Superblock ext2/3/4 (offset variabile in base a s_log_block_size) */
  /* ... */
}
La funzione calcola la prossima posizione saltando i blocchi inutili, garantendo però di non perdersi nulla per strada:
uint64_t search_location_update(const uint64_t location)
{
  unsigned int i;
  uint64_t min = (uint64_t)-1;
  for(i = 0; i < search_location_nbr; i++)
  {
    /* Avanza ogni progressione fino a superare la posizione corrente */
    while(search_location_info[i].offset <= location)
      search_location_info[i].offset += search_location_info[i].inc;
    /* Trova il minimo tra tutte le prossime posizioni candidate */
    if(min > search_location_info[i].offset)
      min = search_location_info[i].offset;
  }
  return min;
}
Validazione rigorosa
Quando trova qualcosa che somiglia a un boot sector, lo valida pesantemente. Guardate come controlla NTFS (ntfs.c):
int test_NTFS(const disk_t *disk_car,
              const struct ntfs_boot_sector *ntfs_header,
              const partition_t *partition, ...)
{
  /* Verifica firma di fine settore */
  if(le16(ntfs_header->marker) != 0xAA55)            return 1;
  /* Campi che devono essere zero in NTFS (non FAT) */
  if(le16(ntfs_header->reserved) > 0)                return 1;
  if(ntfs_header->fats > 0)                          return 1;
  /* Verifica OEM ID */
  if(memcmp(ntfs_header->system_id, "NTFS", 4) != 0) return 1;
  /* Verifica numero settori non nullo */
  if(le64(ntfs_header->sectors_nbr) == 0)            return 1;
  /* Verifica settori per cluster (deve essere potenza di 2, max 128) */
  switch(ntfs_header->sectors_per_cluster) {
    case 1: case 2: case 4: case 8:
    case 16: case 32: case 64: case 128: break;
    default: return 1;
  }
  /* Avvisi di coerenza con la geometria del disco */
  if(le16(ntfs_header->heads) != disk_car->geom.heads_per_cylinder)
    log_warning("heads/cylinder mismatches %u (NTFS) != %u (HD)\n", ...);
  return 0; /* Boot sector NTFS valido */
}
E se trova il backup boot sector, ricalcola al volo l'offset reale della partizione:
int recover_NTFS(disk_t *disk_car,
                 const struct ntfs_boot_sector *ntfs_header,
                 partition_t *partition, ...)
{
  if(test_NTFS(disk_car, ntfs_header, partition, verbose, dump_ind) != 0)
    return 1;

  /* Calcolo dimensione partizione da campi del boot sector */
  part_size = (uint64_t)(le64(ntfs_header->sectors_nbr) + 1)
              * ntfs_sector_size(ntfs_header);

  if(backup > 0) {
    /* Il boot sector trovato è il backup: calcola l'offset reale */
    partition->sb_offset = part_size - disk_car->sector_size;
    partition->part_offset -= partition->sb_offset;
  }
  partition->part_size       = part_size;
  partition->part_type_i386  = P_NTFS;
  partition->part_type_gpt   = GPT_ENT_TYPE_MS_BASIC_DATA;
  return 0;
}
Un'occhiata ai file system supportati
Giusto per darvi un'idea della potenza di fuoco, ecco cosa digerisce:
| File System | File Sorgente | Firma/Offset di Validazione | Note Forensi |
|---|---|---|---|
| FAT12/16/32 | fat.c, fat_adv.c, fat_unformat.c |
0x55AA a offset 0x1FE; OEM ID |
Supporto ricostruzione FAT da cluster; recupero post-formattazione |
| exFAT | exfat.c |
"EXFAT " a offset 3 |
Flash storage e schede SD moderne |
| NTFS | ntfs.c, ntfs_udl.c |
"NTFS" a offset 3; 0xAA55 |
Recupero da backup boot sector; supporto libntfs |
| ext2/3/4 | ext2.c |
Magic 0xEF53 a offset 0x438 |
Distinzione tramite feature flags; ext4 con 64bit flag |
| HFS/HFS+ | hfs.c, hfsp.c |
Signature 0xD2D7 / 0x482B |
Supporto Apple Partition Map (APM) |
| GPT | partgpt.c |
"EFI PART" a LBA 1 |
Recupero da header secondario; validazione CRC32 |
| ReiserFS | rfs.c |
Magic 0x10011001 |
Versioni 3.5, 3.6 e 4 |
| XFS | xfs.c |
"XFSB" a offset 0 |
SGI Journaled File System |
| JFS | jfs.c |
"JFS1" a offset 0x8000 |
IBM Journaled File System |
| Linux Swap | swap.c |
"SWAPSPACE2" a fine pagina |
Rilevamento partizioni swap v1 e v2 |
| LVM2 | lvm.c |
"LABELONE" |
Linux Logical Volume Manager |
| BSD Disklabel | partbsd.c |
Magic 0x82564557 |
FreeBSD/OpenBSD/NetBSD |
| Sun Solaris | sun.c |
Magic 0xDABE |
Disklabel Solaris i386 |
| BeFS | befs.c |
Magic 0x42465331 |
BeOS File System |
Il carving di PhotoRec
Se TestDisk lavora sulla logica, PhotoRec va dritto al sodo: cerca firme nei dati grezzi (file carving). Perfetto per quando hanno piallato tutto.
Come cerca i file
All'avvio, registra le firme per ogni formato supportato (es. in file_jpg.c):
/* Estratto da filegen.c */
void register_header_check(
  const unsigned int offset,    /* Offset della firma nel file */
  const void *value,            /* Bytes della firma (Magic Number) */
  const unsigned int length,    /* Lunghezza della firma */
  int (*header_check)(          /* Callback di validazione semantica */
    const unsigned char *buffer,
    const unsigned int buffer_size,
    const unsigned int safe_header_only,
    const file_recovery_t *file_recovery,
    file_recovery_t *file_recovery_new),
  file_stat_t *file_stat)
{
  file_check_t *fc = MALLOC(sizeof(*fc));
  fc->value        = value;
  fc->length       = length;
  fc->offset       = offset;
  fc->header_check = header_check; /* Funzione di validazione semantica */
  fc->file_stat    = file_stat;
  /* Inserimento ordinato nella lista globale delle firme */
  td_list_add_sorted(&fc->list, &file_check_plist.list, file_check_cmp);
}
Poi usa un indice hash a due livelli per ridurre i confronti (da O(N) a O(1)). Geniale [2].
Il loop di ricerca è questo:
/* Estratto da photorec_check_header.h */
inline static pstatus_t photorec_check_header(
  file_recovery_t *file_recovery,
  struct ph_param *params,
  const struct ph_options *options,
  alloc_data_t *list_search_space,
  const unsigned char *buffer,
  pfstatus_t *file_recovered,
  const uint64_t offset)
{
  const struct td_list_head *tmpl;
  file_recovery_t file_recovery_new;

  /* Scansione dell'indice a due livelli */
  td_list_for_each(tmpl, &file_check_list.list)
  {
    const file_check_list_t *pos =
      td_list_entry_const(tmpl, const file_check_list_t, list);

    /* Secondo livello: indicizzato dal byte discriminante */
    td_list_for_each(tmp, &pos->file_checks[buffer[pos->offset]].list)
    {
      const file_check_t *fc =
        td_list_entry_const(tmp, const file_check_t, list);

      /* Confronto rapido della firma + validazione semantica */
      if((fc->length == 0 ||
          memcmp(buffer + fc->offset, fc->value, fc->length) == 0) &&
         fc->header_check(buffer, read_size, 0,
                          file_recovery, &file_recovery_new) != 0)
      {
        /* Firma trovata e validata: avvia il recupero */
        file_recovery_new.file_stat = fc->file_stat;
        return photorec_header_found(&file_recovery_new, ...);
      }
    }
  }
  return PSTATUS_OK;
}
Validazione profonda (non solo firme)
PhotoRec non si fida solo dei magic number. Per i JPEG, ad esempio, non guarda solo FF D8 FF, ma va a scavare nei marker (SOF, APP0, EXIF) per capire le dimensioni e verificare che non sia spazzatura. Meno falsi positivi, più risultati utili.
Inoltre, tiene traccia dei blocchi già recuperati (alloc_data_t) per non processare due volte lo stesso settore.
Trucchi del mestiere: cache I/O e aree nascoste
Cache per dischi moribondi
Se il disco sta tirando le cuoia, ogni lettura è un rischio. In hdcache.c, c'è un sistema di cache circolare multi-buffer:
/* Estratto da hdcache.c - Funzione cache_pread_aux */
static int cache_pread_aux(disk_t *disk_car, void *buffer,
                           const unsigned int count,
                           const uint64_t offset,
                           const unsigned int read_ahead)
{
  struct cache_struct *data = (struct cache_struct *)disk_car->data;

  /* Ricerca nei buffer esistenti (scansione inversa per località temporale) */
  for(i = 0, cache_buffer_nbr = data->cache_buffer_nbr;
      i < CACHE_BUFFER_NBR;
      i++, cache_buffer_nbr = (cache_buffer_nbr + CACHE_BUFFER_NBR - 1)
                               % CACHE_BUFFER_NBR)
  {
    const struct cache_buffer_struct *cache = &data->cache[cache_buffer_nbr];
    if(cache->cache_offset <= offset &&
       offset < cache->cache_offset + cache->cache_size &&
       cache->buffer != NULL)
    {
      /* Cache hit: copia i dati dal buffer senza accesso al disco */
      memcpy(buffer,
             cache->buffer + offset - cache->cache_offset,
             count);
      return (signed)count;
    }
  }

  /* Cache miss: lettura con read-ahead per ridurre le chiamate future */
  const unsigned int count_new =
    (read_ahead != 0 && count < data->cache_size_min)
    ? data->cache_size_min : count;
  cache->cache_status = data->disk_car->pread(data->disk_car,
                                               cache->buffer,
                                               count_new, offset);
  /* ... */
}
Il read-ahead (leggere un po' più del necessario) vi salva la vita (e il tempo) durante la scansione sequenziale.
Occhio alle aree nascoste (HPA/DCO)
In ambito forense, se un sospettato ha nascosto dati, lo ha fatto probabilmente in HPA o DCO. TestDisk le becca al volo (hidden.c):
/* Estratto da hidden.c */
int is_hpa_or_dco(const disk_t *disk)
{
  int res = 0;
  /* HPA: user_max < native_max indica settori nascosti */
  if(disk->native_max > 0 &&
     disk->user_max < disk->native_max + 1) {
    res = 1;
    log_warning("%s: Host Protected Area (HPA) present.\n",
                disk->device);
    /* DCO: native_max < dco indica ulteriore area nascosta */
    if(disk->native_max < disk->dco) {
      res |= 2;
      log_warning("%s: Device Configuration Overlay (DCO) present.\n",
                  disk->device);
    }
  }
  return res;
}
Se c'è qualcosa, vi avvisa subito nel log.
Sicurezza e catena di custodia
Come ricorda la guida forense ufficiale [3], non si tocca MAI l'originale. TestDisk vi aiuta in due modi:
- Dispositivi Loopback Read-Only: Su Linux, montate il disco così e TestDisk non scriverà un byte [3]:
# Montaggio del disco fisico come loopback read-only losetup -r /dev/loop0 /dev/sdb testdisk /dev/loop0 - Supporto Nativo EWF: Lavorate direttamente sulle immagini E01/EWF crittograficamente verificate.
E per i più paranoici: il codice usa annotazioni ACSL per la verifica formale con Frama-C. In pratica, è dimostrato matematicamente che certe funzioni critiche non vanno in buffer overflow. Mica male per un tool open source.
/*@
  @ requires \valid(file_recovery);
  @ requires valid_file_recovery(file_recovery);
  @ requires \valid(params);
  @ requires valid_ph_param(params);
  @ requires \valid_read(buffer + (0 .. params->blocksize -1));
  @ requires \separated(file_recovery, params, options,
  @                     list_search_space, buffer, file_recovered);
  @ ensures  valid_file_recovery(file_recovery);
  @*/
inline static pstatus_t photorec_check_header(...) { ... }
Tiriamo le somme
Guardando il codice di TestDisk 7.3-WIP, si capisce perché è il re incontrastato. Vent'anni di sviluppo si vedono tutti: astrazione hardware pulita, scansione euristica furba, pattern matching semantico che non sbaglia un colpo e rispetto rigoroso delle procedure forensi.
La trasparenza del codice C e la licenza GPL lo rendono non solo uno strumento potente, ma anche inattaccabile quando dovete presentare i risultati in un'aula di tribunale.
Riferimenti
[1] C. Grenier, TestDisk - Partition Recovery and File Undelete, Documentazione Ufficiale, 2024. [Online]. Disponibile: https://www.cgsecurity.org/wiki/TestDisk
[2] C. Grenier, PhotoRec - Digital Picture and File Recovery, Documentazione Ufficiale, 2024. [Online]. Disponibile: https://www.cgsecurity.org/wiki/PhotoRec
[3] C. Grenier, Forensics: write blockers, Documentazione Sorgente (doc/forensics.rst), Repository Ufficiale TestDisk, 2024.
Codice sorgente analizzato: TestDisk 7.3-WIP (Aprile 2025) — https://github.com/cgsecurity/testdisk

Potrebbe interessarti
AVISE: un framework open source per la valutazione della sicurezza e l'identificazione delle vulnerabilità nei sistemi di intelligenza artificiale
Perché alcune aziende vogliono portare i data center nello spazio?
I sistemi a Chiave Maestra tra storia e attualità