Quanto possiamo fidarci della self-attention e quali sono i suoi limiti? - Autopsia di un LLM (parte quinta)
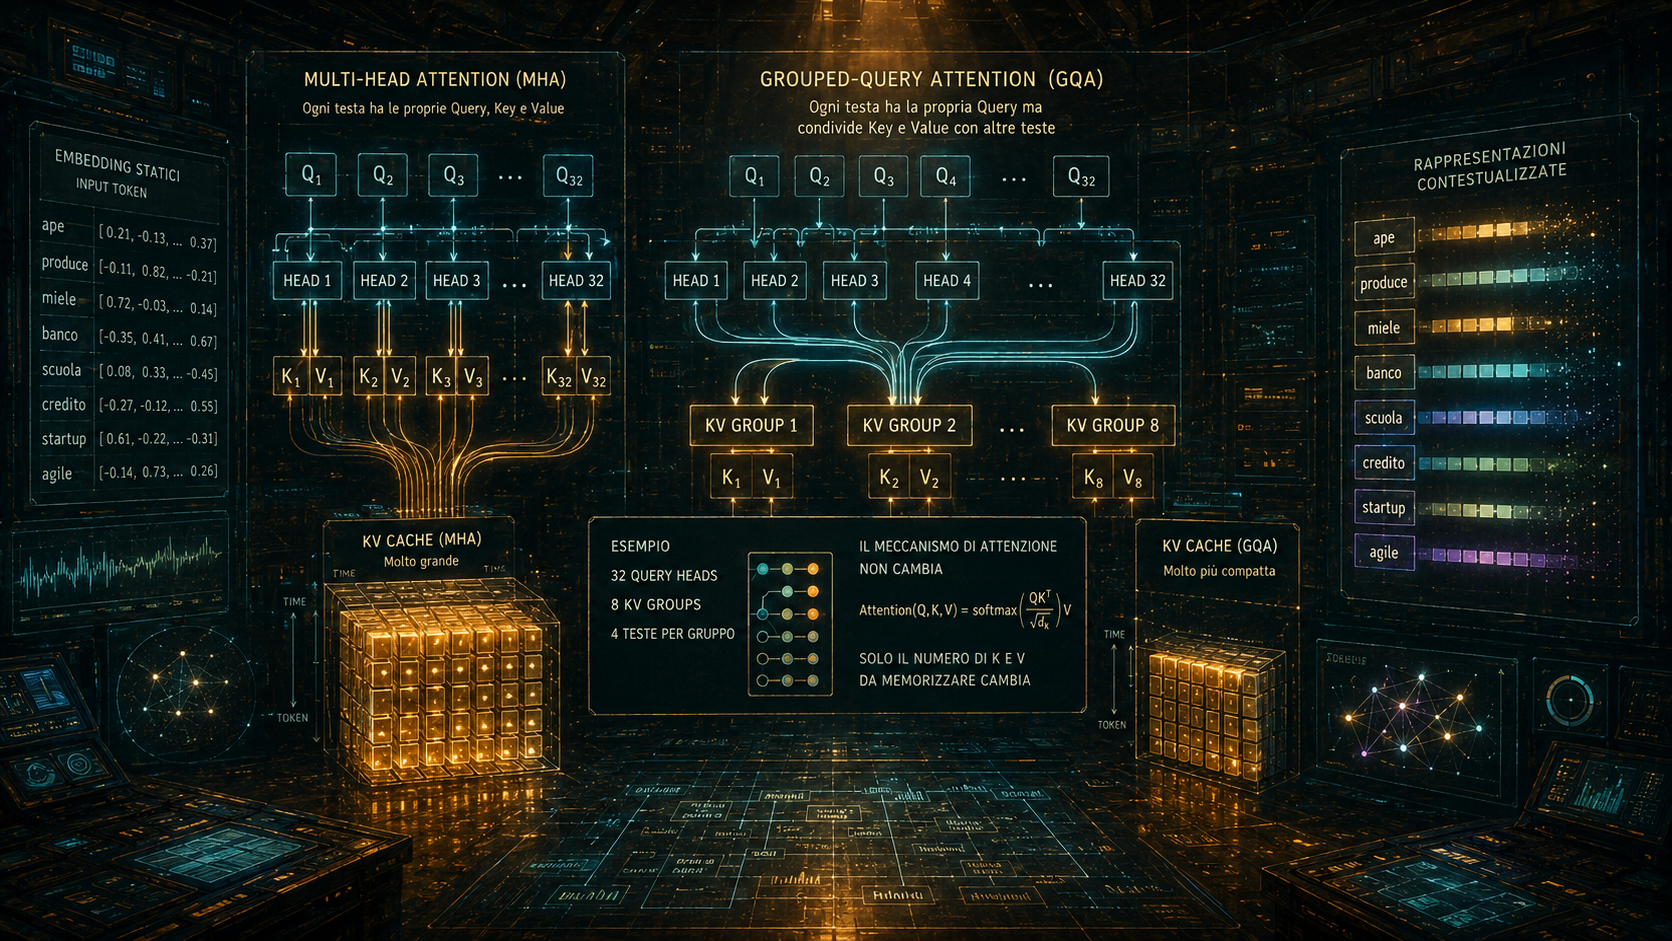
Come rendere la self-attention più efficiente e quali sono i suoi limiti? In questo articolo analizziamo KV cache, Grouped-Query Attention e FlashAttention, per poi affrontare causalità, logica, memoria, verità e sintassi nei moderni modelli linguistici.
/